例えば、
double dot_product(double* v1, double* v2, int n) {
  double r = 0;
  for (int i = 0; i < n; i++) {
    r += v1[i] * v2[i];
  }
  return r;
}
という関数があるとする。実行時になって n == 3 であることが分かり、この計算を何度も行う場合には、
double dot_product_3(double* v1, double* v2) {
  return v1[0] * v2[0]
       + v1[1] * v2[1]
       + v1[2] * v2[2];
}
のような n == 3 に特化したコードを実行時に生成できる。
これにより、ループの条件判定や induction variable の更新などを取り除ける。 一方でコード生成自体にもコストがかかるため、生成したコードを十分に再利用できる場合に特に有効である。
eval` と $ で拡張したものである。` を expression または compound statement に適用した結果を tick-expression と呼ぶ。`4 は実行時に整数定数 4 を計算するコードを指定する。cspec (code specification) 型である。
`4 の型は int cspec。cspec の evaluation type は、そのコードが実行時に計算する値の型。動的に生成される lvalue は vspec (variable specification) 型を持つ。
"hello world" を出力するプログラムを実行時にコンパイルして呼び出す例。
void cspec hello = `printf("hello world\n");
/* Compile and call the result */
(*compile(hello, void))();
cspec 型の値を ` の中に埋め込む例。int cspec c1 = `4;
int cspec c2 = `5;
int cspec c = `(c1 + c2);
$ は specification time に operand を評価し、その値を run-time constant として動的コードに埋め込む。void (*fp)(void);
int x = 1;
/* Compile simple function to demonstrate binding via $ */
fp = compile(`{ printf("$x = %d, x = %d\n", $x, x); }, void);
x = 14;
(*fp)(); /* "$x = 1, x = 14" と表示する */
compile によって instantiate (dynamic compile) する必要がある。
$ で得た run-time constant の値など) を closure に capture する。cspec の runtime representation は対応する closure への pointer である。$ 演算子によって束縛された run-time constant の値cspec は code specification の型で、runtime では対応する closure への pointer として表現される。int (*f)() = compile(c, int); のように compile を呼ぶと、その cspec の closure を引数に対応する CGF を呼び出し、CGF が実際のコード生成の大部分を行う。compile は生成コードを link し、generated locals / parameters に関する情報を reset して、生成コードへの pointer を返す。row が run-time constant なら、その内容を instruction stream に埋め込んだ straight-line な dot-product code を生成できる。
一つ目の方法は、’C の code composition を使って明示的にコードを組み立てる方法。
void cspec code;
int cspec sum = `0;

for (k = 0; k < n; k++)
    if (row[k])
        sum = `(sum + col[$k] * $row[k]);

code = `(return sum;);
/* sum は "a*b + c*d + ..." のようなコード */
`{
    int k, sum = 0;

    for (k = 0; k < $n; k++)
        if ($row[k])
            sum = sum + col[k] * $row[k];

    return sum;
}
が以下のような CGF になる。
for (k = 0; k < c->n; k++) {
    if (((int *)c->row)[k]) {
        /* row[k] == 0 ならコードを生成しない */
        ...
        /* col[k] * row[k] を計算するコードを emit */
        ...
    }
}
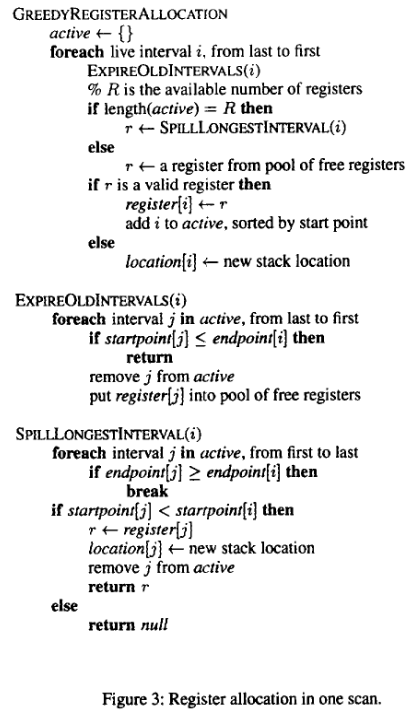
for loop は generated code に残るのではなく、dynamic compile time に CGF 自身が一度だけ実行する。[i, j] とは単純に、instruction stream の i 番目から j 番目まで、両端を含めたすべての instruction とする。v の live interval [m, n] は、v が最初に live になる instruction から最後に live になる instruction まで。
v が live でない区間があっても、近似して interval 全体で live とみなす。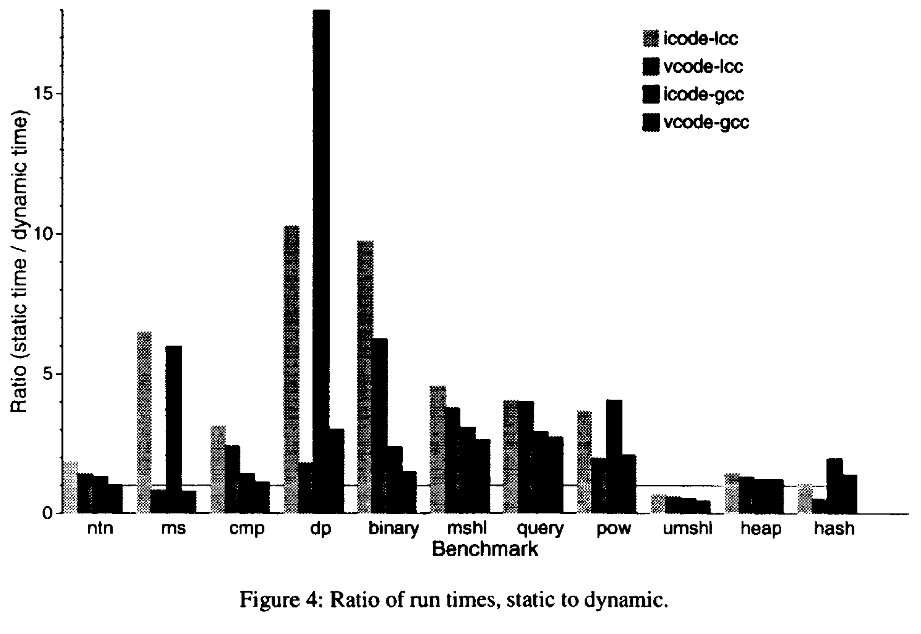
static code の runtime / dynamic code の runtime。dynamic compilation overhead は含まない。icode-lcc は ICODE で生成した dynamic code と lcc で静的コンパイルした code の比較、vcode-gcc は VCODE と gcc の比較、という意味。<a>-<b> は、dynamic backend <a> の生成コードが static compiler <b> のコードに対して何倍速いかを表す。dp) では ICODE の効果が高い。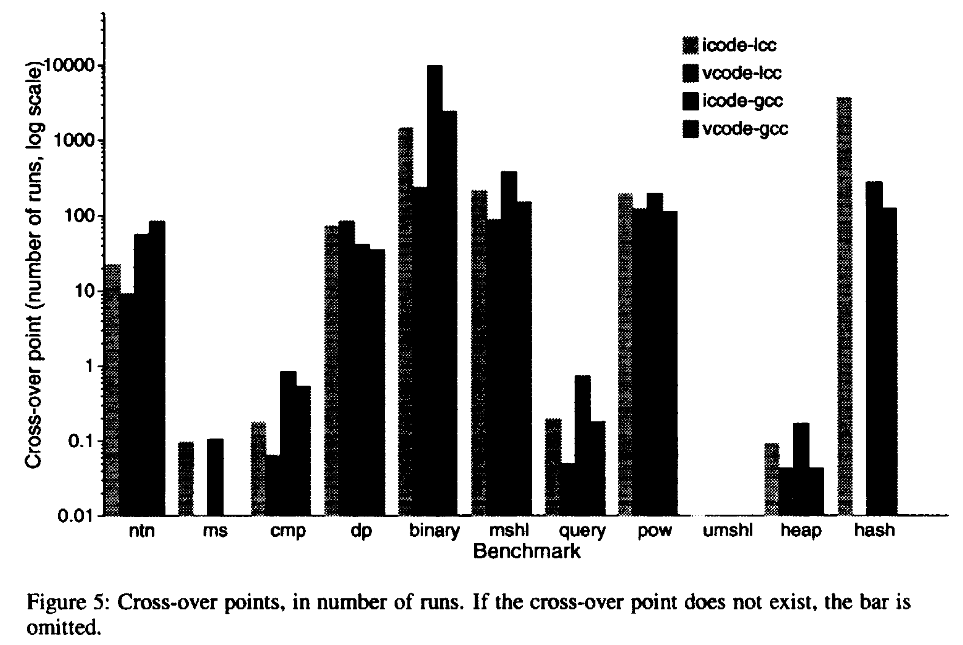
ms の ICODE、cmp、query は 1 回の実行で dynamic compilation cost を回収できる。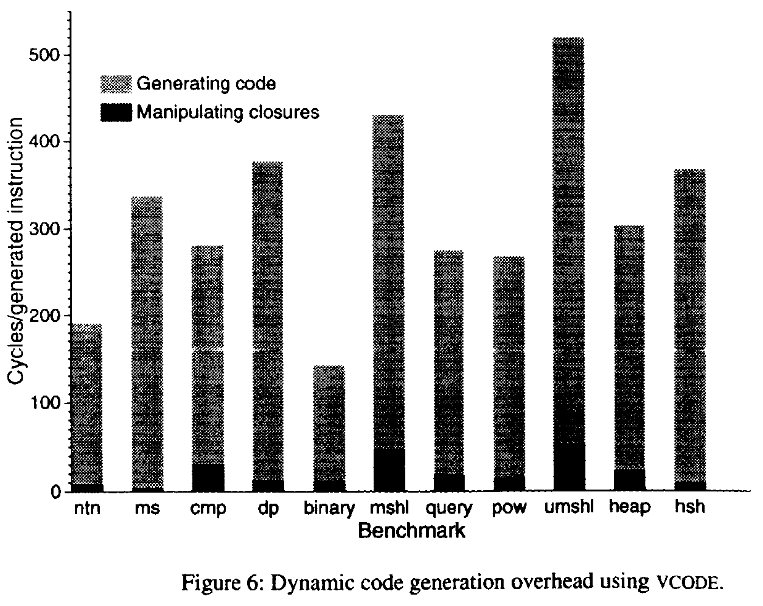
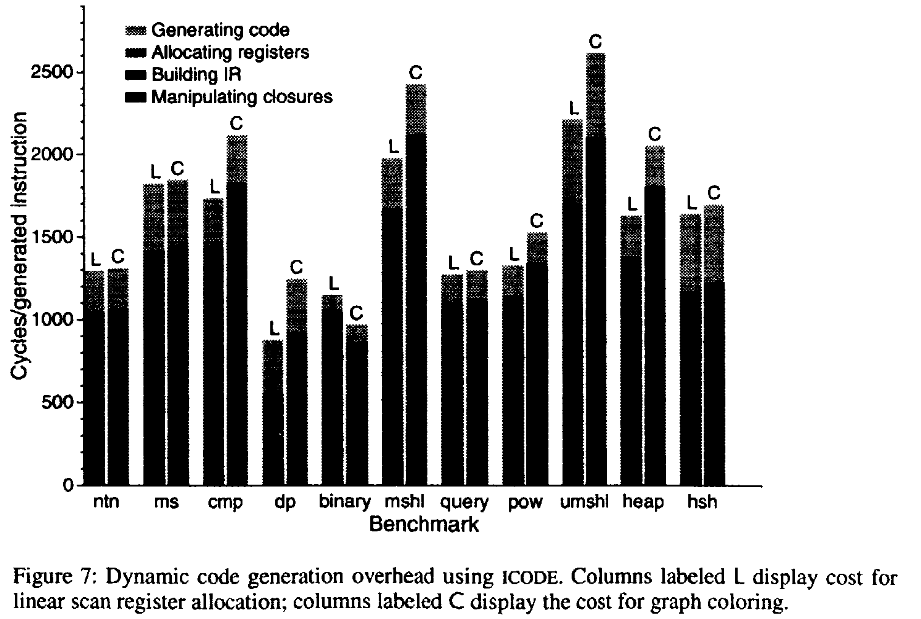
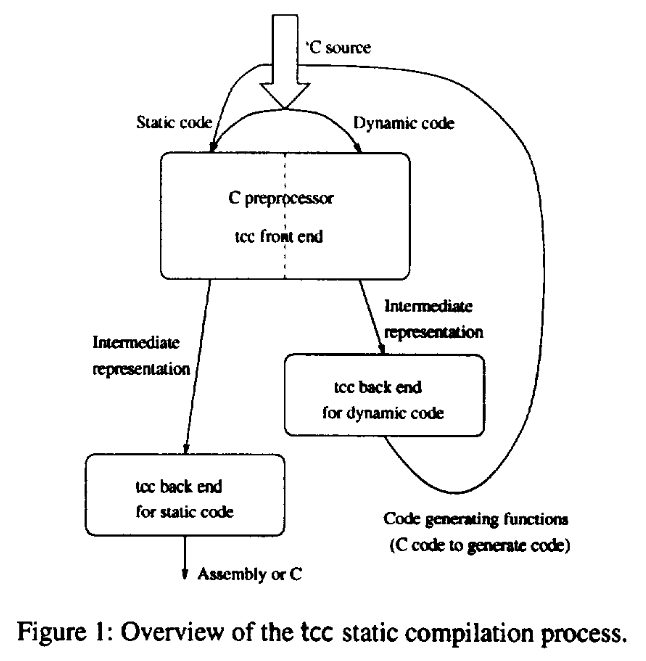
binary。以下では tickc-modernized の dot product 例を direct VCODE backend (-V) で追う。
全体の流れは次のようになる。
Tick-C source
  ↓ static compile
closure を組み立てる C + CGFs
  ↓ specification time
closure / cspec の連鎖
  ↓ compile()
CGFs を実行して VCODE macro を呼ぶ
  ↓
specialized x86-64 machine code
void cspec
mkdot(int row[], int length)
{
    int index;
    int cspec sum = `0;
    int * vspec column = param(int *, 0);

    for (index = 0; index < length; index++) {
        if (row[index] != 0)
            sum = `((@column)[$index] * $row[index] + @sum);
    }
    return `{ return @sum; };
}
row と length は mkdot を呼ぶ specification time に既知。column は generated function の parameter なので、その関数を呼ぶたびに異なる値を渡せる。$index と $row[index] は specification time の値を run-time constant として capture する。@sum はそれまでに作った cspec を現在の quotation に composition する。row[index] == 0 の要素については cspec 自体を追加しないので、生成コードからその積和が消える。Tick-C の quotation は、AST をそのまま runtime に構築するコードではなく、closure / cspec の連鎖を組み立てる C と CGF に変換される。実際の生成 C では、mkdot の loop の各反復で tc_aalloc により closure を確保し、そこへ column、前の sum、index、row[index] を保存している。
sum =
    ((_tc_cspec = ((void *)tc_aalloc(40))),
     /* CGF pointer */
     (*((unsigned long (**)(void *))_tc_cspec) =
          (unsigned long (*)(void *))_tc_cvi_1code),
     /* dynamic parameter */
     (*((_tc_vspec_t *)((char *)_tc_cspec + 16)) = column),
     /* previously constructed cspec */
     (*((_tc_cspec_t *)((char *)_tc_cspec + 24)) = sum),
     /* run-time constants */
     (*((int *)((char *)_tc_cspec + 32)) = index),
     (*((int *)((char *)_tc_cspec + 36)) = row[index]),
     _tc_cspec);
したがって specification time にできるのは machine code ではなく、後からコード生成するための closure graph / cspec chain である。
生成C は https://github.com/akawashiro/tickc-modernized/blob/013c80ce84d4c5cea8e6453e16e750e309501421/dot_product/vcode/dot_product.s.c.formatted#L29-L66 のようになっている。
_tc_cspec_t mkdot(int *row, int length) {
  _tc_closure_t _tc_cspec;
  int index;
  _tc_cspec_t sum =
      ((_tc_cspec = ((void *)tc_aalloc(16))),
       (*((unsigned long (**)(void *))((char *)((unsigned long)_tc_cspec))) =
            (unsigned long (*)(void *))_tc_cvi_0code),
       (*((unsigned int *)(((char *)((unsigned long)_tc_cspec)) + 8)) =
            (unsigned int)0),
       _tc_cspec);
  _tc_vspec_t column = _tc_paramf(8, 0, 0);
  for (index = 0; index < length; index++) {
    if (row[index] != 0)
      sum =
          ((_tc_cspec = ((void *)tc_aalloc(40))),
           (*((unsigned long (**)(void *))(
                (char *)((unsigned long)_tc_cspec))) =
                (unsigned long (*)(void *))_tc_cvi_1code),
           (*((unsigned int *)(((char *)((unsigned long)_tc_cspec)) + 8)) =
                (unsigned int)0),
           (*((_tc_vspec_t *)(((char *)((unsigned long)_tc_cspec)) + 16)) =
                (_tc_vspec_t)column),
           (*((_tc_cspec_t *)(((char *)((unsigned long)_tc_cspec)) + 24)) =
                (_tc_cspec_t)sum),
           (*((int *)(((char *)((unsigned long)_tc_cspec)) + 32)) = (int)index),
           (*((int *)(((char *)((unsigned long)_tc_cspec)) + 36)) =
                (int)(*(int *)((index << 2) + ((char *)((unsigned long)row))))),
           _tc_cspec);
  }
  return ((_tc_cspec = ((void *)tc_aalloc(24))),
          (*((void (**)(void *))((char *)((unsigned long)_tc_cspec))) =
               (void (*)(void *))_tc_cvi_2code),
          (*((unsigned int *)(((char *)((unsigned long)_tc_cspec)) + 8)) =
               (unsigned int)0),
          (*((_tc_cspec_t *)(((char *)((unsigned long)_tc_cspec)) + 16)) =
               (_tc_cspec_t)sum),
          _tc_cspec);
}
同じ生成 C には quotation ごとの CGF も含まれる。積和に対応する _tc_cvi_1code は、まず前の sum の CGF を呼び、その結果に今回の load / multiply / add を VCODE macro で追加する。このあたり に呼び出しているところがある。
il31 = _spec__1_0->code((void *)_spec__1_0);

/* column[index] */
v_ldii(il30, il30, (long)4 * _rtc__1_0);

/* * row[index] */
v_cmuli(il30, il30, (long)_rtc__1_1);

/* + previous sum */
v_addi(il31, il31, il30);
compile(mkdot(row, 6), int) では、この cspec chain に対応する CGF 群が呼ばれ、direct VCODE backend では VCODE macro がほぼ one-pass で x86-64 machine code を emit する。
compile() が runtime の executable buffer に生成したコードは runtime_debug/generated-code.objdump で確認できる。row = {2, 0, -3, 0, 4, 0} の場合、生成コードの本体は概ね次の処理になっている。
load column[0]
imul 2
add

load column[2]
imul -3
add

load column[4]
imul 4
add

return
実際の disassembly でも、column[0], column[2], column[4] に対応する offset 0, 8, 16 から load し、係数 2, -3, 4 を immediate operand として乗算している。元の for loop、終了判定、index の更新、row[index] == 0 の branch は generated code には残らない。
実際に生成された機械語は https://github.com/akawashiro/tickc-modernized/blob/dot-product-example/dot_product/vcode/runtime_debug/generated-code.objdump のようになっている。`jmp 命令などがなくループが展開されていることがわかる。
generated-code.bin:     file format binary


Disassembly of section .data:

0000000000000000 <.data>:
   0:	55                   	push   rbp
   1:	48 89 e5             	mov    rbp,rsp
   4:	53                   	push   rbx
   5:	41 54                	push   r12
   7:	41 55                	push   r13
   9:	41 56                	push   r14
   b:	41 57                	push   r15
   d:	48 81 ec 08 00 00 00 	sub    rsp,0x8
  14:	48 89 fb             	mov    rbx,rdi
  17:	48 89 5d d0          	mov    QWORD PTR [rbp-0x30],rbx
  1b:	bb 00 00 00 00       	mov    ebx,0x0
  20:	4c 8b 65 d0          	mov    r12,QWORD PTR [rbp-0x30]
  24:	45 8b 24 24          	mov    r12d,DWORD PTR [r12]
  28:	45 89 e0             	mov    r8d,r12d
  2b:	45 69 c0 02 00 00 00 	imul   r8d,r8d,0x2
  32:	45 89 c4             	mov    r12d,r8d
  35:	41 89 d8             	mov    r8d,ebx
  38:	45 89 e1             	mov    r9d,r12d
  3b:	45 01 c8             	add    r8d,r9d
  3e:	44 89 c3             	mov    ebx,r8d
  41:	4c 8b 65 d0          	mov    r12,QWORD PTR [rbp-0x30]
  45:	45 8b 64 24 08       	mov    r12d,DWORD PTR [r12+0x8]
  4a:	45 89 e0             	mov    r8d,r12d
  4d:	45 69 c0 fd ff ff ff 	imul   r8d,r8d,0xfffffffd
  54:	45 89 c4             	mov    r12d,r8d
  57:	41 89 d8             	mov    r8d,ebx
  5a:	45 89 e1             	mov    r9d,r12d
  5d:	45 01 c8             	add    r8d,r9d
  60:	44 89 c3             	mov    ebx,r8d
  63:	4c 8b 65 d0          	mov    r12,QWORD PTR [rbp-0x30]
  67:	45 8b 64 24 10       	mov    r12d,DWORD PTR [r12+0x10]
  6c:	45 89 e0             	mov    r8d,r12d
  6f:	45 69 c0 04 00 00 00 	imul   r8d,r8d,0x4
  76:	45 89 c4             	mov    r12d,r8d
  79:	41 89 d8             	mov    r8d,ebx
  7c:	45 89 e1             	mov    r9d,r12d
  7f:	45 01 c8             	add    r8d,r9d
  82:	44 89 c3             	mov    ebx,r8d
  85:	89 d8                	mov    eax,ebx
  87:	e9 00 00 00 00       	jmp    0x8c
  8c:	48 81 c4 08 00 00 00 	add    rsp,0x8
  93:	41 5f                	pop    r15
  95:	41 5e                	pop    r14
  97:	41 5d                	pop    r13
  99:	41 5c                	pop    r12
  9b:	5b                   	pop    rbx
  9c:	5d                   	pop    rbp
  9d:	c3                   	ret