eBPF で Linux の動作を観察する
Linux 上でプログラムを動かしていると、「ネットワーク通信はどれくらいの頻度で起こっているのか」「ファイルの読み込みはいつ発生しているのか」といったことが気になることがあります。
今回は eBPF を使って、そのような Linux 内部の動きを観察します。まず sched_switch が起きたらフラグを立てる小さなプログラムを作り、その後で発展的な利用方法と観測対象を整理します。
最後に自分が作っている procinsh を紹介します。
eBPF とは何か
eBPF は、Linux kernel にプログラムをロードし、決められた地点で実行させるための仕組みです。 例えばスレッドが切り替わる地点にプログラムを attach すると、そのイベントが発生するたびに kernel 内で自分の処理が呼ばれます。 イベントの引数を読み、時刻を記録し、kernel 内で集計してから userspace に結果を渡せます。
eBPF を使ってみる
使用環境は Ubuntu 26.04 LTS(x86_64)、Linux kernel 7.0.0-15-generic、clang 21.1.8、libbpf 1.6.3、bpftool 7.7.0 です。
本文の kernel ソースは、この Ubuntu kernel のベースである Linux v7.0 を参照します。
sched_switch を確認する
tracepoint1 は、kernel のソースコードにあらかじめ置かれた観測用のフックです。 そこに処理を登録すると、kernel がその地点を通るたびに登録した処理が呼ばれます。 eBPF プログラムをこのフックに attach できます。
sched_switch は、scheduler が現在のタスクから次のタスクへ切り替える際の tracepoint です。
Linux v7.0 では、__schedule() の trace_sched_switch() 呼び出し の直後に context_switch() があります。
イベントには prev_pid、next_pid、それぞれの名前と優先度、切り替え前の状態などが含まれます。
定義と各フィールドへの代入は include/trace/events/sched.h で確認できます。
今回はイベントの引数は読み取らず、イベントが起きて BPF が実行されたことだけを確認します。
今回示すサンプルは次のファイル群で構成されます。
hello.bpf.c:eBPF 側のコードhello.c:userspace 側のコードrun.sh:ビルド・実行用スクリプトhello.skel.h:skeleton ヘッダの生成例
eBPF 側のコード
hello.bpf.c の中身はこのようになっています。
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>

int ran;

SEC("tracepoint/sched/sched_switch")
int on_switch(void *ctx)
{
    ran = 1;
    return 0;
}

char LICENSE[] SEC("license") = "GPL";
SEC("tracepoint/sched/sched_switch") で attach 先を指定します。
sched_switch が起きると on_switch() が呼ばれ、初期値 0 の ran を 1 にします。
ctx にはイベントの情報が渡されますが、ここでは使いません。
userspace 側のコード
hello.c は、BPF プログラムをロードして attach し、1 秒後に ran を読みます。
#include <stdio.h>
#include <unistd.h>
#include "hello.skel.h"

int main(void)
{
    struct hello_bpf *skel = hello_bpf__open_and_load();
    if (!skel)
        return 1;

    int err = hello_bpf__attach(skel);
    if (!err) {
        sleep(1);
        int ran = skel->bss->ran;
        puts(ran ? "sched_switch: BPF ran!" : "sched_switch: no event observed");
        err = !ran;
    }
    hello_bpf__destroy(skel);
    return err ? 1 : 0;
}
hello_bpf__open_and_load() でロードし、hello_bpf__attach() でイベントに結び付けます。
sleep(1) の間にも scheduler は動くので、BPF が実行されれば ran が 1 になります。
hello_bpf__destroy() で detach して終了します。
hello.skel.h は bpftool gen skeleton が生成するヘッダです。
BPF のバイトコードとロード用の関数を含み、BPF 側のグローバル変数にも skel->bss->ran としてアクセスできます。
生成結果の全体は hello.skel.h にあります。
struct hello_bpf 内の ran に関係する定義を抜き出すと、次のようになります。
struct hello_bpf__bss {
    int ran;
} *bss;
この bss を通して、BPF 側の int ran を userspace から読むことができます。
以下のような流れでコンテキストスイッチから hello.c までつながっています。
sched_switch
    ↓
BPF: ran = 1
    ↓
userspace: ran を読む
    ↓
"sched_switch: BPF ran!"
ビルド、実行する
Ubuntu 26.04 で依存パッケージをインストールし、実行します。
sudo apt install build-essential clang pkg-config libbpf-dev libelf-dev zlib1g-dev \
    linux-tools-common "linux-tools-$(uname -r)"
bash articles/ebpf-hello/run.sh
run.sh が BPF オブジェクト、skeleton、userspace の実行ファイルを順番にビルドし、sudo で実行します。
イベントを受け取れれば、次のメッセージを表示して終了します。
sched_switch: BPF ran!
eBPF の発展的な利用方法
BPF Map と userspace
今回の ran は、BPF プログラムと userspace の間で状態を共有しています。
より多くの状態を保持したい場合は、用途に合わせて Map を定義します。
Map は、eBPF プログラムがデータを保存するための kernel 内のデータ構造です。 プログラムの呼び出しをまたいで値を保持でき、BPF プログラムと userspace の間でデータを共有するためにも使えます。 例えば process ID を key、イベントの発生回数を value とする Hash Map を用意すれば、process ごとのイベント数を集計できます。
| Map | 形 | ドキュメント |
|---|---|---|
| Hash | key から value を引く | BPF_MAP_TYPE_HASH, with PERCPU and LRU Variants |
| Array | 0 から始まる整数 index | BPF_MAP_TYPE_ARRAY and BPF_MAP_TYPE_PERCPU_ARRAY |
| Per-CPU Hash | CPU ごとに別の value を持つ Hash | BPF_MAP_TYPE_HASH, with PERCPU and LRU Variants |
| Per-CPU Array | CPU ごとに別の value を持つ Array | BPF_MAP_TYPE_ARRAY and BPF_MAP_TYPE_PERCPU_ARRAY |
eBPF では何を観測できるのか
sched_switch 以外にも、次のようなポイントを観測できます。
| レイヤ | 観測したいこと | attach 先の例・ソース |
|---|---|---|
| process | fork / exec / exit | sched_process_fork / sched_process_exec / sched_process_exit(sched.h) |
| CPU / scheduler | 実行時間、context switch、実行待ち時間 | sched_switch / sched_wakeup(sched.h) |
| syscall | enter / exit、引数、戻り値、latency | raw_syscalls:sys_enter / sys_exit(syscalls.h) |
| file I/O | open / read / write / close | syscall のイベント、VFS 関数への kprobe2 / fentry(read_write.c) |
| block I/O | request / completion / latency | block_rq_issue / block_rq_complete(block.h) |
| network | connect / accept、再送、packet、socket | syscall、tcp_retransmit_skb(tcp.h)、XDP / tc |
| memory | page fault / allocation / reclaim | x86 の page fault tracepoint、kmem.h、vmscan.h |
| kernel function | 特定関数の引数・戻り値・所要時間 | vfs_read() への kprobe / kretprobe、fentry / fexit |
| userspace function | アプリや共有ライブラリの関数呼び出し | fopen() への uprobe / uretprobe(attach の例) |
eBPF の実例
bpftrace
bpftrace は、eBPF を使って Linux を動的にトレースするための高水準言語とツールです。 tracepoint、kprobe、uprobe、perf event などを短いスクリプトから利用でき、scheduler、system call、I/O、userspace の関数呼び出しなどを観測できます。
例えば、この記事で使った sched_switch も次の 1 行で観測できます。
sudo bpftrace -e 'tracepoint:sched:sched_switch { @switches = count(); }'
実行中に sched_switch が発生するたびに @switches が増え、終了時に合計が表示されます。
今回のサンプルでは C で eBPF プログラムを書き、libbpf でロードして attach しましたが、bpftrace では同じ tracepoint への attach と集計を短い記述で行えます。
sched_switch を使った例は One-Liner Tutorial の Scheduler Tracing にもあります。
procinsh
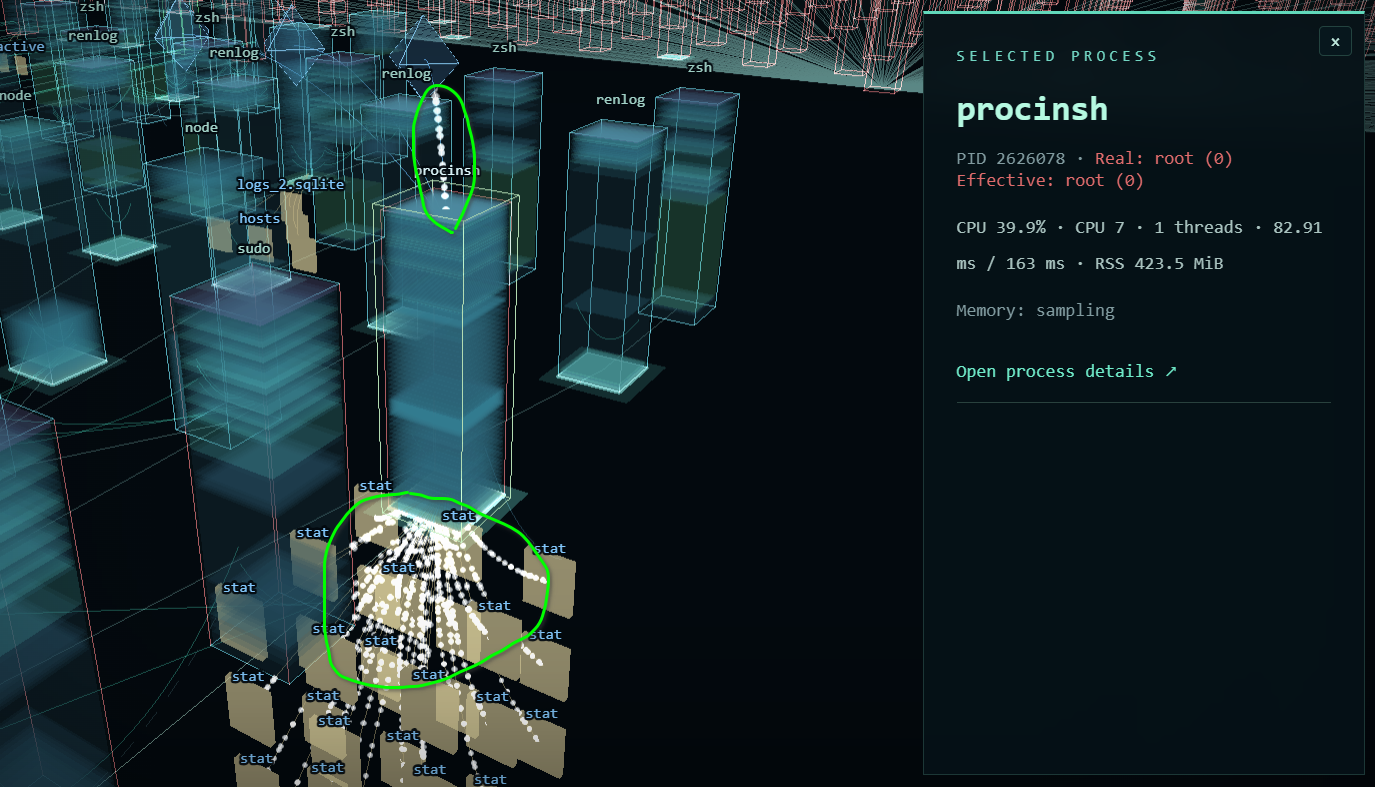
procinsh は、自分が作っている Linux の活動を 3D で眺めるためのソフトウェアです。 ここではファイル I/O やソケット通信のイベントを eBPF で取得し、ホスト上でデータが流れる様子を可視化しています(ファイル I/O の実装、ソケット通信の実装)。下の画像で白い丸で表示されているデータは eBPF 経由で取得したデータです。
まとめ
eBPF を使うと、Linux 内部のイベントに処理を attach して、自分が必要な情報を集められます。
今回の例では sched_switch に attach し、BPF 側でフラグを立て、userspace から読んで実行を確認しました。